


一次生成 15 秒
1.1 最长 10 秒,1.2 可以到 15 秒,按 1 秒调节。一条完整的社媒广告、产品讲解或有好几段情节的场景,一次就能生成,不用再拼两条。在提示词里给每段动作写上时间,镜头可以一镜到底走完全部节拍。
Google 视频模型 · 2026年11月5日 发布
Google 最新的 Omni Flash 视频模型。从一段提示词、一张图片,或几张参考图加短视频开始,单条最长 15 秒,自带音效和对白;360p 试稿,最高 4K 出片,每条 17 积分起。
科普短片、无人机穿越、一镜拉远和产品镜头,声音都是模型和画面一起生成的。
和 1.1 相比,1.2 能做更长的片子,更贴近参考图,对白更自然,每秒消耗的积分也更少。
1.1 最长 10 秒,1.2 可以到 15 秒,按 1 秒调节。一条完整的社媒广告、产品讲解或有好几段情节的场景,一次就能生成,不用再拼两条。在提示词里给每段动作写上时间,镜头可以一镜到底走完全部节拍。
人脸、服装、包装字体和品牌色,1.2 会更稳地对齐你给的参考图,从第一帧保持到最后一帧。下面的并排画面里,左边是参考海报,中间是 1.1,右边是 1.2,两者都按同一要求逐层搭出这张竖版海报。
把台词放进引号,并写明谁来说。1.2 的对白更自然、口型更清楚,同一场戏里的几个说话人也能分开。示例中,主持人来自一张参考图,她拿起另一张参考图里的花瓶,转向镜头说出台词。
两个版本都能从文字、首帧或参考图加短视频开始,都自带声音,分辨率和画幅也一样;区别在时长、尾帧、参考上限和价格。
| 规格 | Gemini Omni 1.2 Flash | Gemini Omni 1.1 Flash |
|---|---|---|
| 发布时间 | 2026年11月5日 | 2026年8月27日 |
| 时长 | 3–15 秒 | 3–10 秒 |
| 参考图 | 最多 6 张 | 最多 10 张 |
| 尾帧 | 不支持 | 支持 |
| 10 秒 720p 积分 | 164 积分 | 200 积分 |
| 15 秒 720p 积分 | 246 积分 | 最长 10 秒 |
| 适合 | 大多数新片,最长 15 秒 | 需要落在指定尾帧,或超过 6 张参考图时 |
1.1 和 1.2 都具备这些能力,项目从 1.1 换到 1.2,做法不用变。
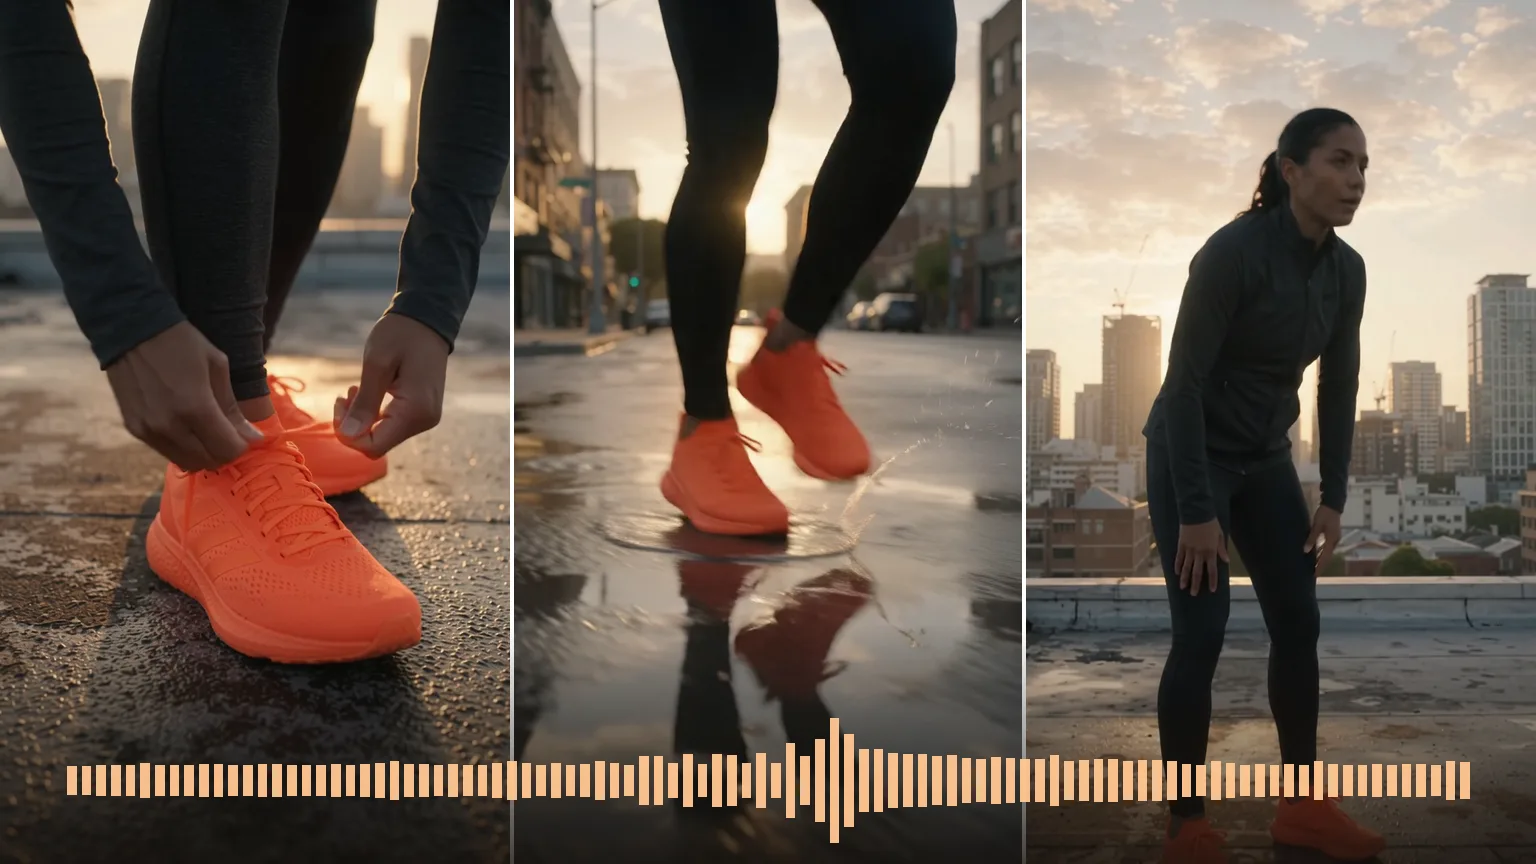
音效、环境声和人声与画面一起生成,不用另做一遍配音,也没有开关要记。想听到什么,就写进提示词来引导。
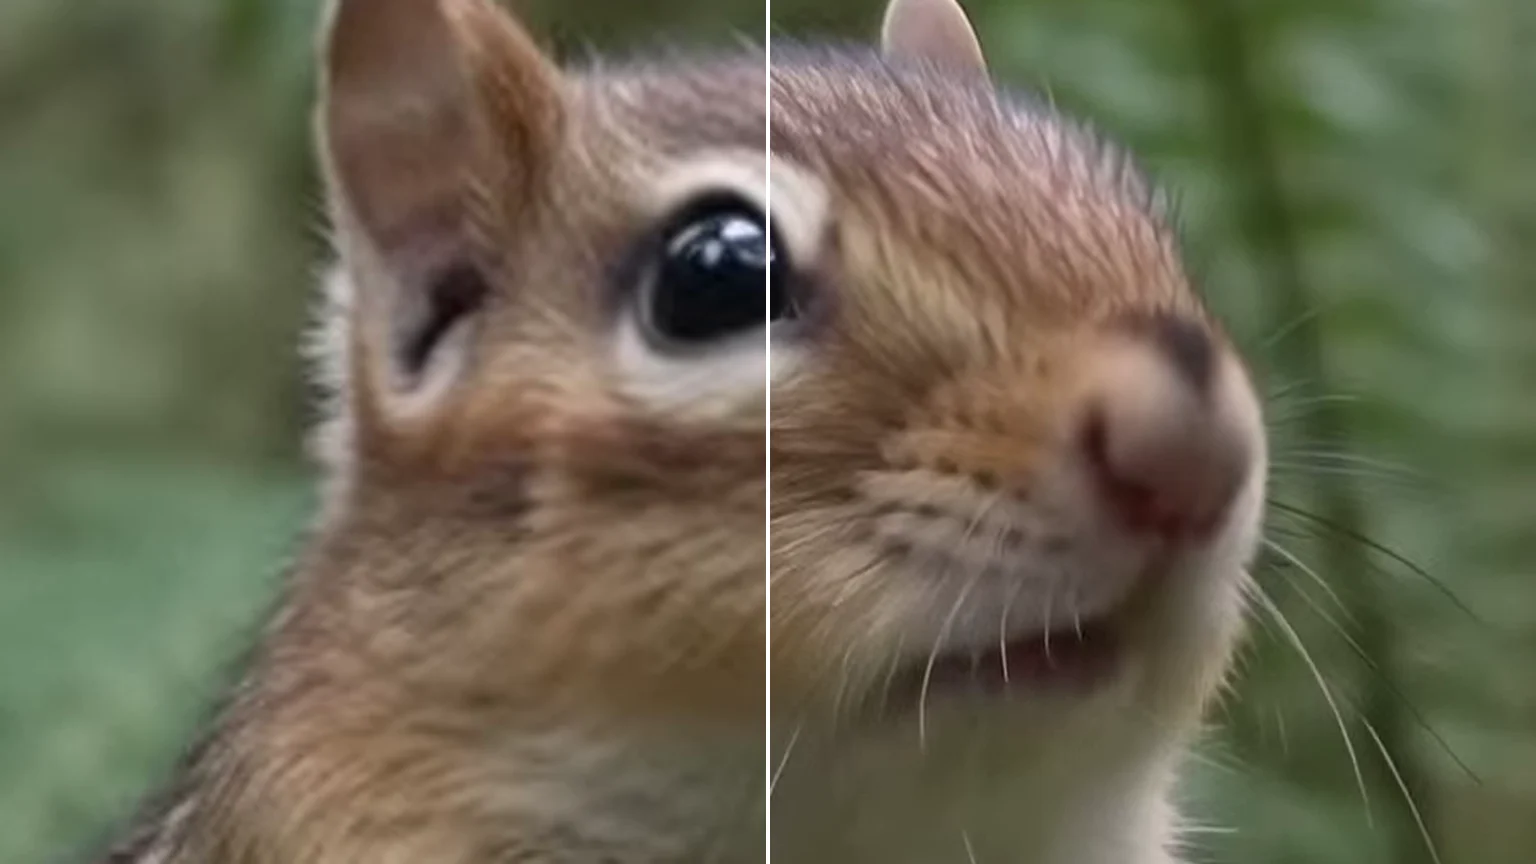
先用 360p 试构图、节奏和台词,满意了再选更高档位出片,最高 4K;高档位是在模型渲染结果上做的上采样。每次渲染都是重新生成,试稿和成片的细节可能不同。
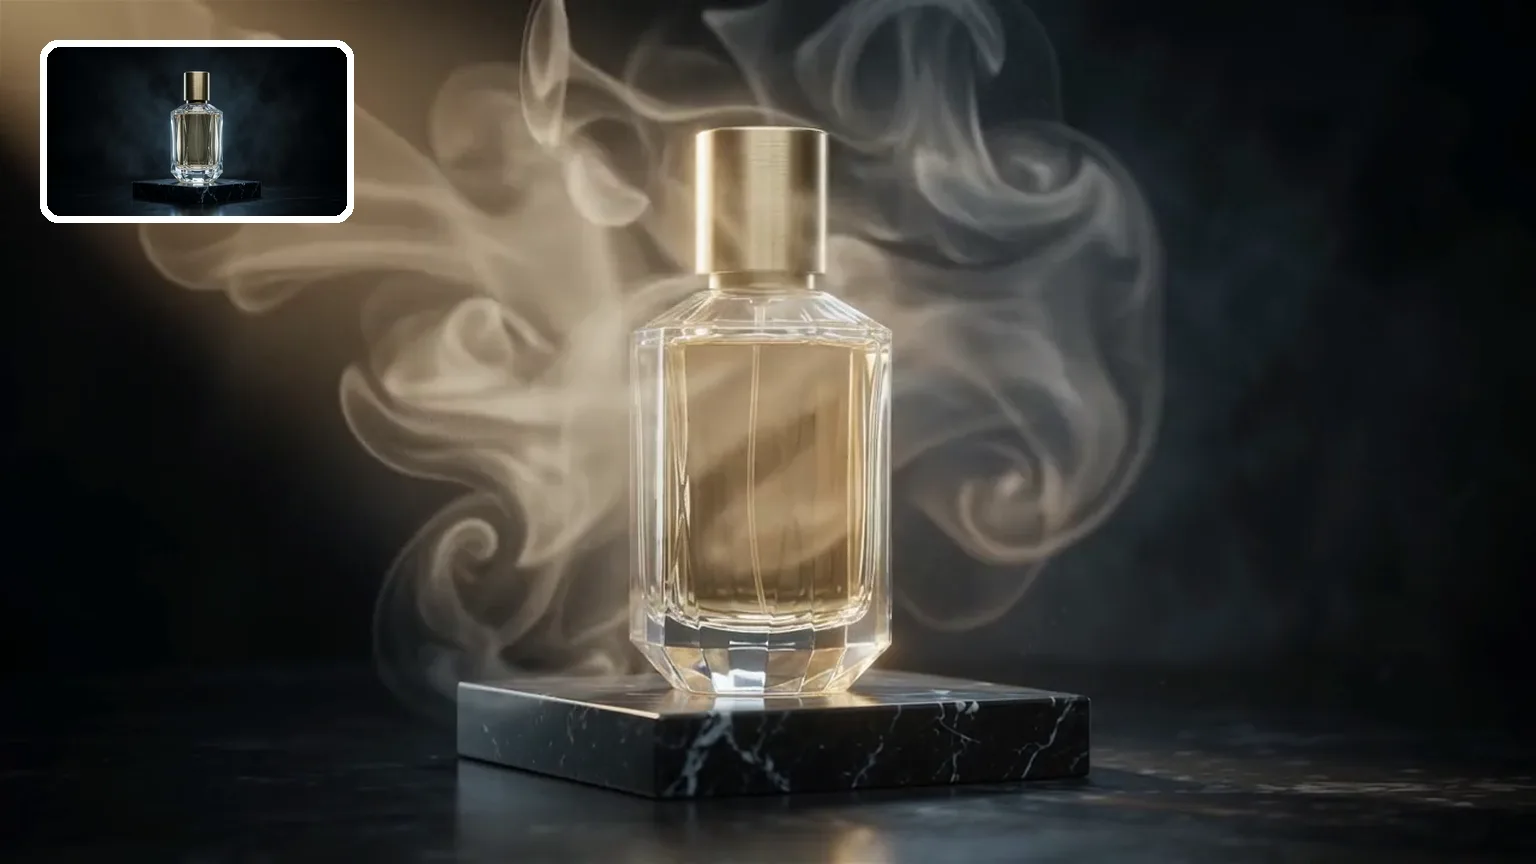
上传一张图作为开头画面,再写清楚哪里在动。视频从你的画面开始,适合产品展示、人像,以及需要动起来的静态图。
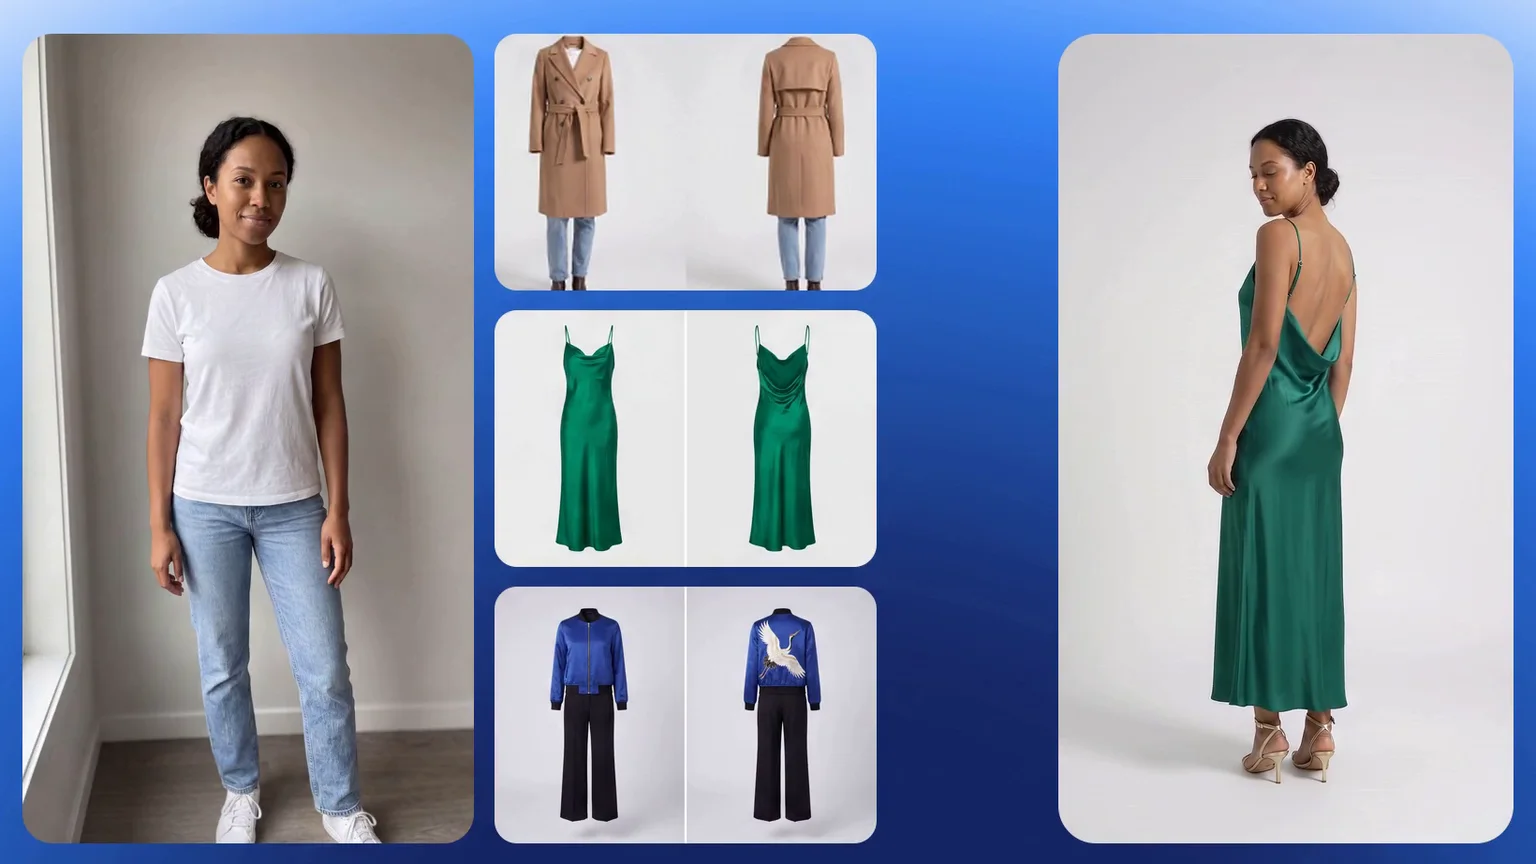
给它人物、产品或风格参考图,再加几秒视频参考动作或运镜,在提示词里写明每个文件负责什么。人脸、服装和产品在换角度、换镜头时仍然认得出来,虚拟试穿和商品展示片正需要这一点。
这四个模型都在 Oeneo AI 的同一个工作台里,不用离开页面就能切换。积分按带声音的 8 秒 720p 视频计算,这是四者都支持的时长。
| 规格 | Gemini Omni 1.2 Flash | Veo 3.1 | Seedance 2.5 | Kling 4.0 |
|---|---|---|---|---|
| 开发方 | ByteDance | Kling | ||
| 时长 | 3–15 秒 | 4, 6, 8 秒 | 4–30 秒 | 3–30 秒 |
| 分辨率 | 360p–4K | 720p–4K | 480p–1080p | 720p–1080p |
| 画面比例 | 16:9, 9:16 | 16:9, 9:16 | 21:9, 16:9, 4:3, 1:1, 3:4, 9:16 | 16:9, 9:16, 1:1, 21:9 |
| 声音 | 始终生成 | 可开关 | 可开关 | 始终生成 |
| 尾帧 | 不支持 | 不支持 | 支持 | 支持 |
| 参考输入 | 6 张图、3 段视频 | 不支持 | 30 张图、10 段视频、10 段音频 | 10 张图、5 段视频 |
| 修改已有视频 | 不支持 | 不支持 | 不支持 | 支持 |
| 8 秒 720p 积分 | 132 积分 | 640 积分Veo 3.1 Fast: 240 | 757 积分 | 252 积分 |
| 适合 | 低成本,最长 15 秒 | 需要反向提示词的短镜头 | 长片、大量参考素材 | 修改手上已有的视频 |
复制一条提示词,粘到上方工作台对应的任务里,再换成你自己的主体和场景。Gemini Omni 读得懂平实的描述,真正拉开差距的是写清运镜、声音和台词。
文生视频
提示词长度 450
A single continuous 15-second shot on a rainy neon street at night. 0–5 s: close-up of a street musician tuning a red electric guitar under a shop awning, raindrops bouncing off his amp. 5–10 s: the camera slowly pulls back to reveal a small crowd gathering under umbrellas. 10–15 s: he strikes the first chord, the crowd cheers, and the camera rises above the umbrellas. Sound: rain, the guitar, the crowd. No music bed, no on-screen text, no logos.写出运镜
推近、拉远、环绕、升起:每个镜头一个明确的动词,画面更稳。
把声音写清楚
列出音效、环境声和谁在说话;没写的部分全靠模型猜。
写明哪里必须留白
产品或服装要保持干净时,写上 no logos、no text、no brand marks。
指望用尾帧收尾
在 Oeneo AI 上,1.2 只从一张图开始。把结尾画面写进提示词;如果必须停在你给的那张图上,换用 Gemini Omni 1.1 Flash。
用参考素材做 15 秒
参考生视频最长 10 秒。要更长的镜头,从文字或一张图片开始。
台词不写说话人
两个人对话时,引号前不写名字,台词可能从另一个人嘴里说出来。
留了空子
A runner laces up bright orange sneakers on a rooftop at sunrise, then sprints toward the camera.
写死了
A runner laces up plain bright orange running shoes with no logos, no stripes and no brand marks on a rooftop at sunrise, then sprints toward the camera.
没写明的细节会被模型补上,有时会补出很像某个真实品牌的条纹或标志。写清哪些地方必须保持素净,产品和服装镜头才干净。
以下是 Gemini Omni 1.2 Flash 的数值;Gemini Omni 1.1 Flash 的时长、参考上限和价格见上方版本对比表。
成片之后还能继续:加长、提高清晰度、让新角色照着它的动作动起来,或者换别的模型试同一个想法。
Gemini Omni 1.2 Flash 是 Google 的视频生成模型,于 2026年11月5日 发布,是 Gemini Omni 1.1 Flash 的后继版本。它可以把一段提示词、一张图片,或几张参考图加短视频,变成 3 到 15 秒的视频,声音和画面一起生成。在 Oeneo AI 上,它就在本页顶部的工作台里。
不免费。每次生成都消耗积分,价格随所选分辨率和时长变化,点击生成前按钮上会显示准确数值。新账号注册赠送 10 积分。
在上方工作台选择文生视频、图生视频或参考生视频,写好提示词或上传图片和参考素材,设好时长、分辨率和画面比例,然后点击生成。不需要 API key,也不需要 Google 账号,生成的视频会保存在你的作品记录里。
在 Oeneo AI 上不能:这里的 Gemini Omni 只生成新视频,也不提供多轮对话式编辑。想修改已有视频,把工作台切到视频转视频,选一个支持编辑的模型,例如 Kling 4.0;想把视频变长或变清晰,用视频延长或视频放大工具。
不支持。声音由 Gemini Omni 自己生成,想要什么音效、什么样的嗓音、说哪句台词,直接写进提示词。
Google 会在每条 Gemini Omni 视频里嵌入不可见的 SynthID 水印,用来识别 AI 生成内容。它不影响画面观感,Oeneo AI 也不会去除它。
Google 的安全过滤会在生成前拦下部分提示词和参考图。换一种说法描述,或者换一张图,再生成一次。
Google 表示,快速的体育动作和复杂的物理效果还在改进,冲线、物体碰撞这类画面可能要多试几次。你也可以在同一个工作台里,把同一段提示词交给其他模型,例如 Kling 4.0 或 Seedance 2.5。